A Balanced Data Diet: Addressing the Exploration Bottleneck in Mega-Scale RL for Robot Control
A Balanced Data Diet: Addressing the Exploration Bottleneck in Mega-Scale RL for Robot Control
Octi Zhang · Mateo Guaman Castro · Patrick Yin · Ignacio Dagnino · Abhishek Gupta · Rosario Scalise · Byron Boots
一句话结论
SGS(Success-Guided Sampling)解决的不是“新的策略网络”或“新的 PPO 更新规则”,而是大规模并行 RL 里经验分配的瓶颈:uniform reset 会把大量环境浪费在策略已掌握或完全解不了的配置上。它为每个固定任务配置维护最近 100 次布尔成功记录,用 Beta 形核给中等成功率区域更高权重,再经 softmax 抽样,同时用数值下限保证困难配置仍会被偶尔重访。作者在最多约 1M 并行环境的仿真中验证:1M 环境下多地形 ANYmal-D 成功率约 73%,高于 PLR 的 54%;Franka 螺母装配约 70%,而 uniform 和 PLR 分别约 6% 和 5%。不过,操作任务是逐任务训练策略,不是单个通用策略;实机 UR5e 三个任务零样本成功率从 37.5% 到 94% 不等,sim-to-real 差距仍真实存在。
关键词
摘要
内容摘要
直观理解
可以把 SGS 理解为“外层练习调度器”:PPO 和奖励基本保持不变,但在每个 episode 结束后,系统根据当前策略对各个题目的通过率决定下一批并行环境练什么。通过率接近 0 的题目太难,通过率接近 1 的题目太容易,而中间区域最可能同时有成功与失败样本,能产生区分策略好坏的学习信号。
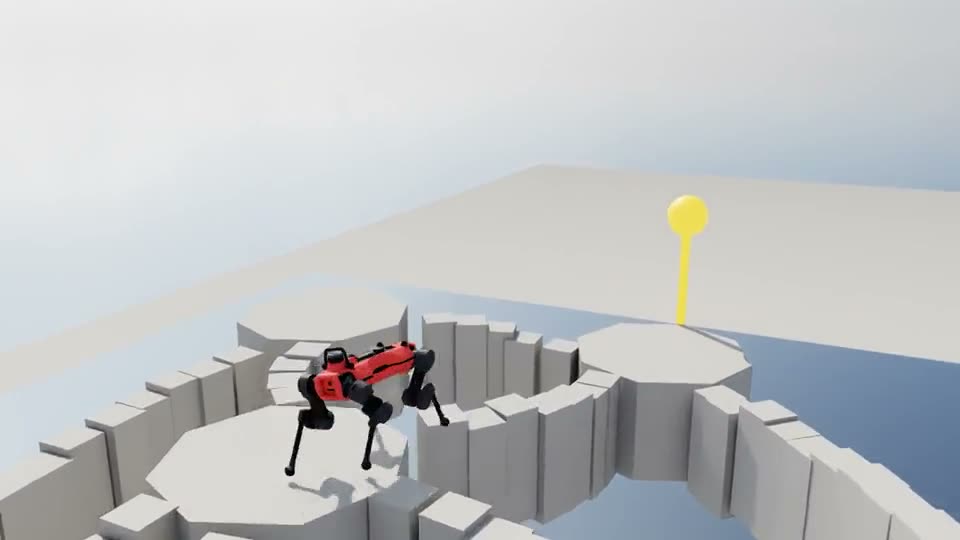
这个设计的关键不是简单贪心挑选当前成功率最高的任务,而是让所有配置都有非零概率。这样,随着策略在其他配置上获得可迁移技能,早期完全失败的困难配置仍能被重新估计;已经接近掌握的配置也会被抽样,避免成功率估计过期。项目页展示的调度过程正是这种从均匀覆盖到边界集中、再随掌握程度移动的现象。
背景与问题
为什么做
机器人 sim-to-real RL 已经在足式运动、灵巧操作和装配上有一批成功案例,但常见流程依赖任务专属 shaped reward、人工课程或示范:reward 可能诱导意外行为,课程超参需要调,示范增加采集成本,最后每个新任务仍像一个工程项目。OmniReset 等方法用程序化生成多样中间状态 reset,缓解从零探索的困难,也让大规模并行仿真更有价值。
问题缺口
只是提供广泛 reset 还不够。若 uniform 从整个分布抽题,随着策略成长,一批环境里会有很多配置已经稳定成功,另一些则完全失败;前者梯度信号饱和,后者缺少成功样本,真正处在学习边界的配置反而得不到足够算力。并行环境越多,这种浪费越可能放大,表现为 scaling 收益下降甚至训练崩溃。论文要补的缺口是:在不用任务专属课程的前提下,持续把并行环境分配到当前策略“学得动”的配置上。
方法
方法概述
SGS 是标准 PPO 外面的小型自适应抽样外环。训练前先从任务分布采样固定配置池;每个 episode 结束时记录该配置的布尔成功结果,用最近 H=100 次结果的均值估计成功率 p_i,再由 Beta 形核和 softmax 决定下一个配置。策略更新本身仍使用 PPO; locomotion 与 manipulation 分别共享一个较简单的领域级奖励函数。
核心机制
对配置 i,SGS 使用 mode-concentration 形式的 Beta 核 Beta(1+κt, 1+κ(1−t)) 计算权重,其中 t 是目标成功率、κ 控制集中程度。公式等价于用 (p_i+ε)^{κt}(1−p_i+ε)^{κ(1−t)} 生成未归一化密度,再取 log 后经温度 T 的 softmax 抽样。ε 保证 0/1 成功率不产生奇异值,也让每个配置保有非零抽样概率;实现中还会给权重和温度设下限。论文的常用设置是:locomotion N=104,000、t=0.66、κ=5、ε=1e-8;manipulation N=32,768、t=0.5、κ=1、ε=1e-4;两者均用 H=100、T=2。
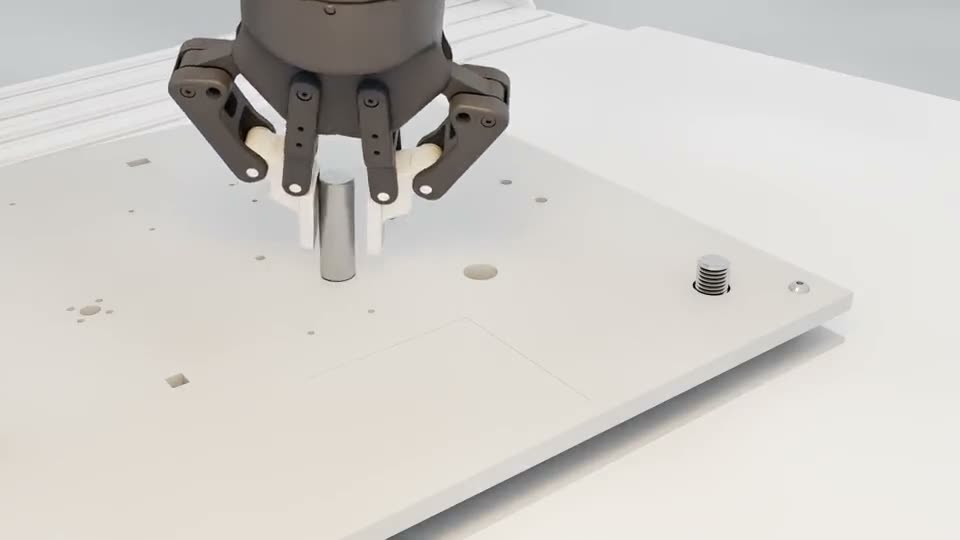
方法拆解
- 任务配置:
τ=(s_0,g,e),包含初始状态、目标和环境配置。locomotion 中对应地形类型/几何、起点与目标位姿;manipulation 中对应 reset 配置、物体/机器人初始状态和固定装配目标。 - 离散配置池:locomotion 使用 13 类地形、每类 2 个 seed、10 个难度/变体档、20 个起点与 20 个目标,合计 104,000 个配置;manipulation 每个任务使用 32,768 个碰撞检查过的配置,并在 Near-Goal、Stable Grasp、Reaching 三类 reset 间均衡。
- 在线成功率估计:每个配置保留最近 100 次布尔结果的循环缓冲。成功率不是静态难度,而是任务难度与当前策略迁移能力的联合函数,因此必须随训练更新。
- 非零边界采样:Beta 核偏好接近目标成功率
t的配置;ε防止完全成功/完全失败配置被永久排除,使困难配置可以被重新发现,已掌握配置也能被校准。 - 领域级共享奖励:locomotion 所有地形共享一个由终端成功/失败和少量运动、姿态、接触、前进方向正则组成的奖励;manipulation 所有装配任务共享装配成功、异常终止惩罚与动作幅度/变化率/关节速度正则。论文强调这不是每个地形或每个装配任务单独调 reward。
- 大规模执行:作者保持 PPO mini-batch 数不变,让 batch size 随环境数扩展,在最多约 1M 并行环境中比较 uniform、linear curriculum、PLR、SFL 和 SGS。locomotion 训练约 36 小时,Franka 螺母装配约 128 小时,UR5e 螺母装配约 335 小时。
关键要点
- SGS 改变的是 reset/task configuration 的抽样分布,不改变 PPO 的策略目标;它更像“根据当前能力排练习题”的外层调度。
- 该方法依赖离散、预先覆盖好的配置池;论文明确不生成新任务,也不学习连续配置空间的评分表示。
- 操作与运动设置必须分开读:locomotion 是单一策略覆盖 13 类地形;manipulation 是每个任务单独训练策略,只是共享奖励形式和 SGS 机制。
结果
- Scaling:1M 并行环境下,ANYmal-D 多地形 locomotion SGS 平均成功率约 73%,PLR 约 54%,uniform 与 linear curriculum 均为 0;Franka 螺母装配 SGS 约 70%,uniform 约 6%,PLR 约 5%。
- 较小规模也能有效:4K 环境下,locomotion SGS 约 45.6%,SFL final 约 25.5%,uniform/PLR/linear 在论文图表中基本没有学会;32K 时 SGS 约 49.4%,SFL final 约 5.1%,但 SFL best checkpoint 可达约 42.1%,说明 SFL 后期退化而 SGS 更稳。
- 任务难度边界:UR5e rod-in-hole 在 32K 环境下 SGS 能成功,uniform 与 PLR 为 0;到 256K 环境三类方法都约 98%。这说明 SGS 的收益不是所有任务恒定不变,简单任务达到足够规模后 uniform 也可追平。
- 逐任务操作结果:UR5e 六个 NIST 任务中,较简单插入/连接任务 SGS 与 uniform 大体相当;最难螺母装配在 256K 环境下 SGS 90.04%,uniform 48.83%,PLR 59.77%。Franka 与 UR5e 控制接口不同,不能把两者的螺母装配数值直接当作同平台比较。
- 实机零样本:state/point-cloud teacher 经 DAgger 蒸馏为 RGB 学生后,不使用真实数据或微调,直接部署到 UR5e。螺母 18/48 成功(37.5%),rod 30/49(61%),gear mesh 47/50(94%);first-try success 分别为 12.5%、28.57%、76%,吞吐分别为 0.23、0.71、3.08 successes/min。
- 消融边界:去掉 Near-Goal reset 后,rod-in-hole 在测试配置中完全失败;去掉 Stable Grasp 会降低均值并出现 seed 崩溃;去掉 Reaching 影响很小。1M 环境 Franka 螺母任务中,不用重力课程为 69.4%,用课程为 70.2%,说明主结果并不是必须依赖该课程。
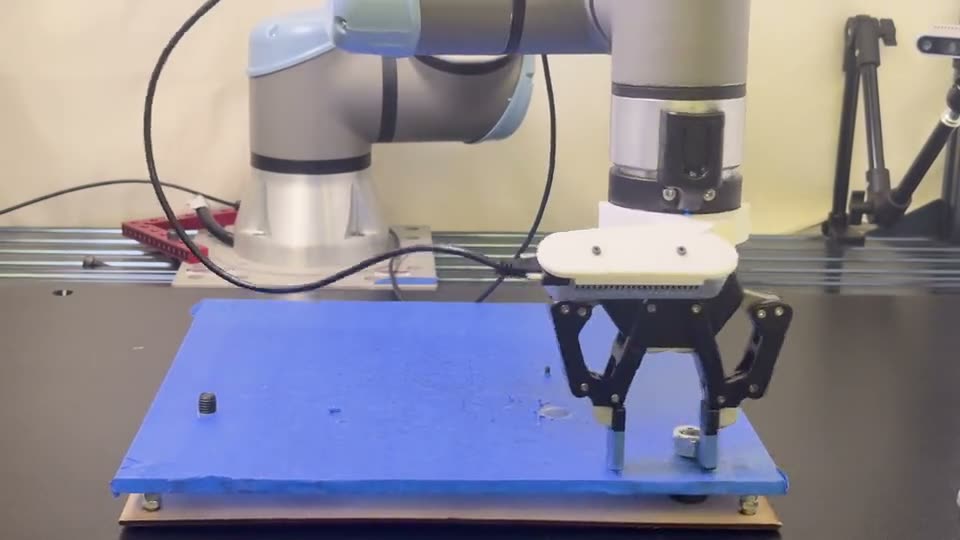
结果速览表
| 实验 | 规模 / 设置 | SGS | 主要对照 | 读法 |
|---|---|---|---|---|
| ANYmal-D 多地形 | 1M env,3 seeds | 73% | PLR 54%;uniform/linear 0% | SGS 明显改善大规模多地形训练 |
| Franka 螺母装配 | 1M env,3 seeds | 70% | uniform 6%;PLR 5% | 高难接触任务收益最大 |
| UR5e rod-in-hole | 32K env | 能成功 | uniform/PLR 为 0 | 低规模下提前获得有效信号 |
| UR5e 六任务仿真 | 64K/256K env | 80%–96%;螺母 90.04% | 简单任务与 uniform 相近 | 收益集中在难任务,不是普适恒定加速 |
| UR5e 实机零样本 | 48–50 trials | 37.5%–94% | 仿真 RGB 学生 89.05%–96.42% | 螺母存在明显 sim-to-real 差距 |
洞察
- 有效数据量不等于环境数量:1M 个并行环境只有分配到有信息量的配置上才产生学习信号。SGS 把 scaling 问题从“更多样本”细化为“更多边界样本”,这是本文最有价值的工程视角。
- 成功率是便宜的在线难度信号:不需要学习值函数、TD error 或额外教师,只用每个离散配置最近 100 次布尔结果就能调度;这让方法简单、容易叠加到既有 PPO 管线。
- 保留非零探索很重要:如果只贪心采中等成功率,策略在其他配置上学到的迁移能力可能无法激活困难配置;
ε下限让抽样分布保持覆盖,这是简单方法能稳定训练的关键。 - 任务池覆盖与任务选择同样关键:去掉 Near-Goal 后学习完全失败,说明 SGS 只能在已给 reset 分布中挑题,不能替代构造有用中间状态的方法。
和已有方法的关系
- PLR 用 TD-error/GAE 等学习信号加 staleness 做优先级;SGS 直接用任务级布尔成功率,成本更低,也避免把 advantage 估计噪声误当成任务难度。
- SFL 同样强调
p(1−p)型 learnability;SGS 可看成用 Beta 核、滚动窗口、目标成功率和非零下限稳定的变体。论文的贡献不是宣称全新课程原则,而是证明该简单变体在超大规模机器人控制里有效。 - OmniReset 提供 Near-Goal/Stable Grasp/Reaching 等多样 reset;SGS 是其外层经验分配器。二者互补:一个决定可用题目池,一个决定当前练哪些题。
可借鉴点
- 训练大规模机器人 RL 时,应报告每个任务配置的成功率分布和抽样质量随时间的变化,而不是只报告平均成功率和总环境数。
- 新任务先构造离散、碰撞检查、覆盖关键中间状态的配置池,再用滚动成功率调度,是比手工难度序列更容易跨任务复用的 baseline。
- 做蒸馏时使用 point-cloud teacher、对称 reset/success 与 held-out DAgger 环境,可以缩小 teacher 与 RGB 学生观测差距;这部分的工程经验即使不采用 SGS 也有价值。
风险与判断
局限
- SGS 维护离散配置集合的成功率;连续或远大于 104K/32.768K 的任务空间需要分层或学习式评分,论文尚未解决。
- 它只从给定分布抽样,不自动构造新任务;reset 覆盖缺失时可能失效,Near-Goal 消融已经显示这一点。
- 实机成功率明显低于仿真,螺母任务仅 37.5%,first-try 12.5%,吞吐 0.23 successes/min;这仍是演示与评估,不是生产级可靠性。
- 1M 并行环境、数十到数百小时训练和多 GPU 仿真构成高算力门槛;论文没有给出完整经济成本或能效比较。
- 操作实验是逐任务独立策略,不是证明一个跨任务通用策略;Franka 与 UR5e 的控制接口、频率和夹爪也不同,数值不能横向等同。
- 截至读取时代码未发布,第三方无法检查实现细节、评估脚本和配置抽样统计;论文数值应视为作者报告结果。
适用场景
- 适合已经有大规模并行仿真、程序化 reset/任务配置池,且瓶颈集中在探索或经验分配的足式运动与接触密集装配任务。
- 适合作为替代手工任务难度课程的低成本外层 baseline,尤其在能在线获得明确成功/失败信号的任务中。
- 不适合直接用于无法定义可靠布尔成功、任务空间连续且覆盖不足、或算力无法支撑大量并行 rollout 的场景;也不应把它当作已解决 sim-to-real 的通用方案。
最终判断
- 方向清楚、结果强,但边界同样清楚。 SGS 用极简单的成功率调度解决了大规模 RL 中“会做/做不了之间”的经验分配问题,1M 环境的 locomotion 与 Franka 装配结果值得关注;但它的适用性依赖离散任务池、成功谓词和仿真规模,实机螺母成功率也提醒我们 sim-to-real 差距仍在。等待代码和第三方复现前,最好把它视为一个强 baseline 与系统设计原则,而不是可直接套用的通用训练方案。
相关主题
继续阅读
上一篇
UNITAS: A 3D-Native World Action Model for Embodied Manipulation
UNITAS 不是把深度图简单接到 VLA 上,而是把“看见什么、身体怎么动、世界如何响应”都写成同一度量 3D 坐标系里的点轨迹。机器人夹爪和人类手被表示为 action flow,环境点位移被表示为 scene flow;一个物理时间 tokenizer 让不同采样率与轨迹长度的数据共享接口。1.7B 模型在 LIBERO 达 99.8%,LIBERO-Plus 达 89.1%,RoboTwin Clean/Randomized 达 92.94%/93.04%;在动作条件场景预测中,Moving ADE 从 PointWorld 的 0.656 cm 降到 0.427 cm。
下一篇
RoboRSI: Stable, Efficient, and Reusable Robot Self-Evolution in Complex Real-World Environments
RoboRSI 的核心不是一个新的端到端机器人策略,而是一套让执行经验变成可维护能力的系统机制。它把任务组织为任务族、复合技能、原子任务和基础技能,要求每个节点有明确接口、责任和后置条件;失败后由 Reviewer 沿实际调用路径定位最早失败节点,Manager 只允许在这个节点拥有的子树内修改,并通过功能测试与近期执行回放验证后才发布。这个“先定位责任、再局部修改、再门控发布”的流程,显著减少了修补漂移和全局技能库污染。 证据上有两点最值得记住:其一,在 104 轮、24 小时真机移动清理开发中,系统把失败修复转化为技能树中的局部能力和回归测试,最终两个场景 9 次指定放置全部由现场人员确认成功且无人工接管;其二,复合技能消融在 600 个匹配 episode 上将成功率从 21.5% 提升到 29.0%,同时中位 token、模型调用和墙钟时间分别下降 29.4%、27.2% 和 17.0%。但主仿真结果是在线自我改进口径,不能和固定策略 Pass@k 混读;真机曲线也是开发记录而非固定任务重复实验。