ManipForce: Force-Guided Policy Learning with Frequency-Aware Representation for Contact-Rich Manipulation
ManipForce: Force-Guided Policy Learning with Frequency-Aware Representation for Contact-Rich Manipulation
Geonhyup Lee · Yeongjin Lee · Kangmin Kim · Seongju Lee · Sangjun Noh · Seunghyeok Back · Kyoobin Lee
一句话结论
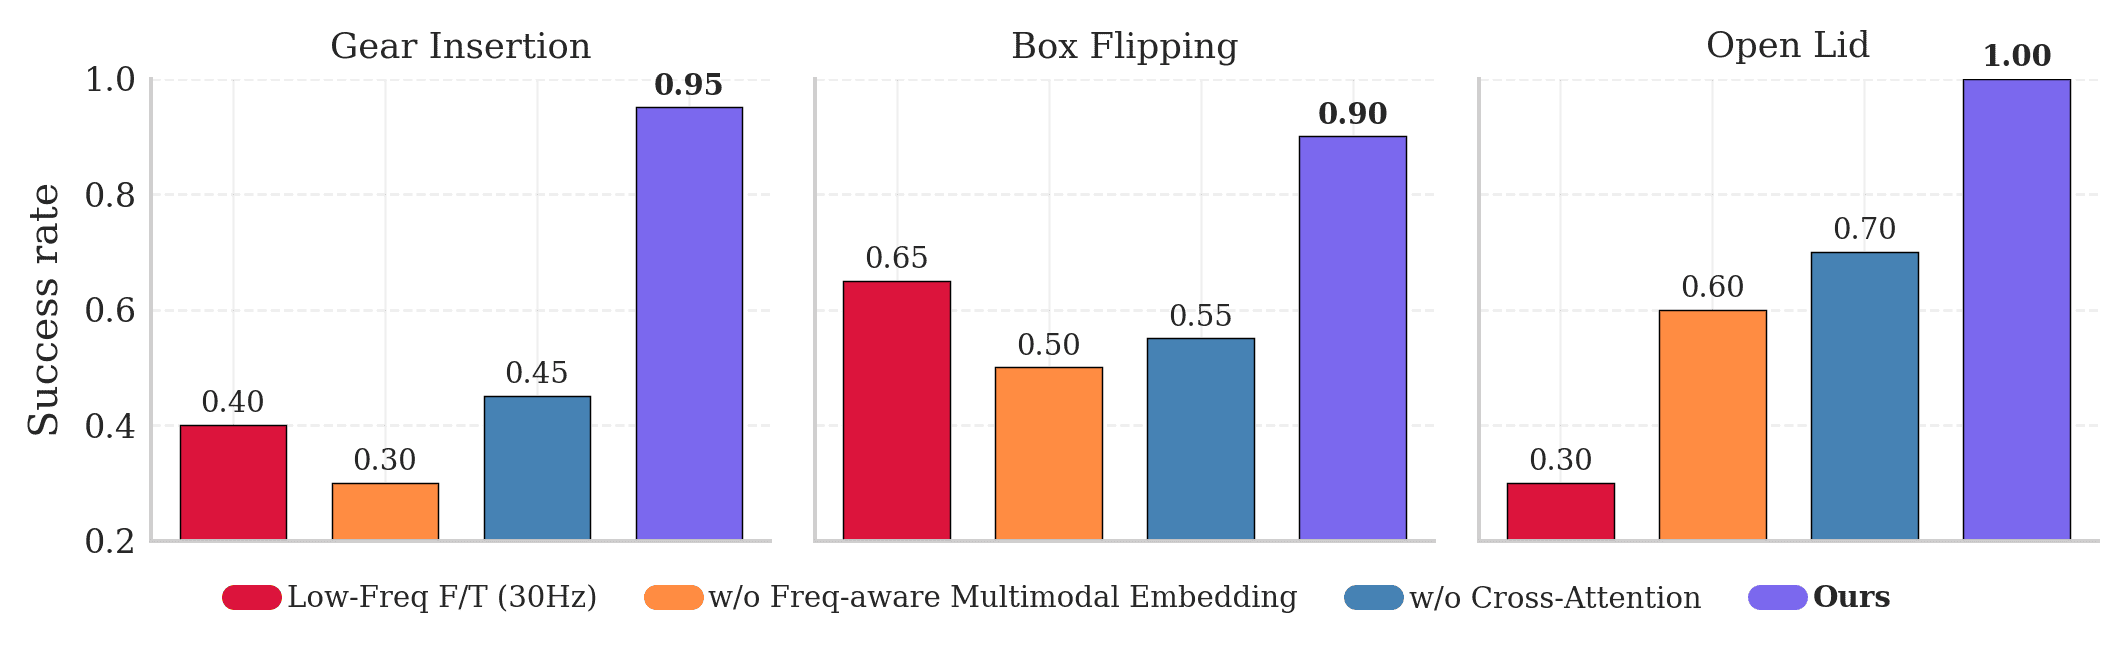
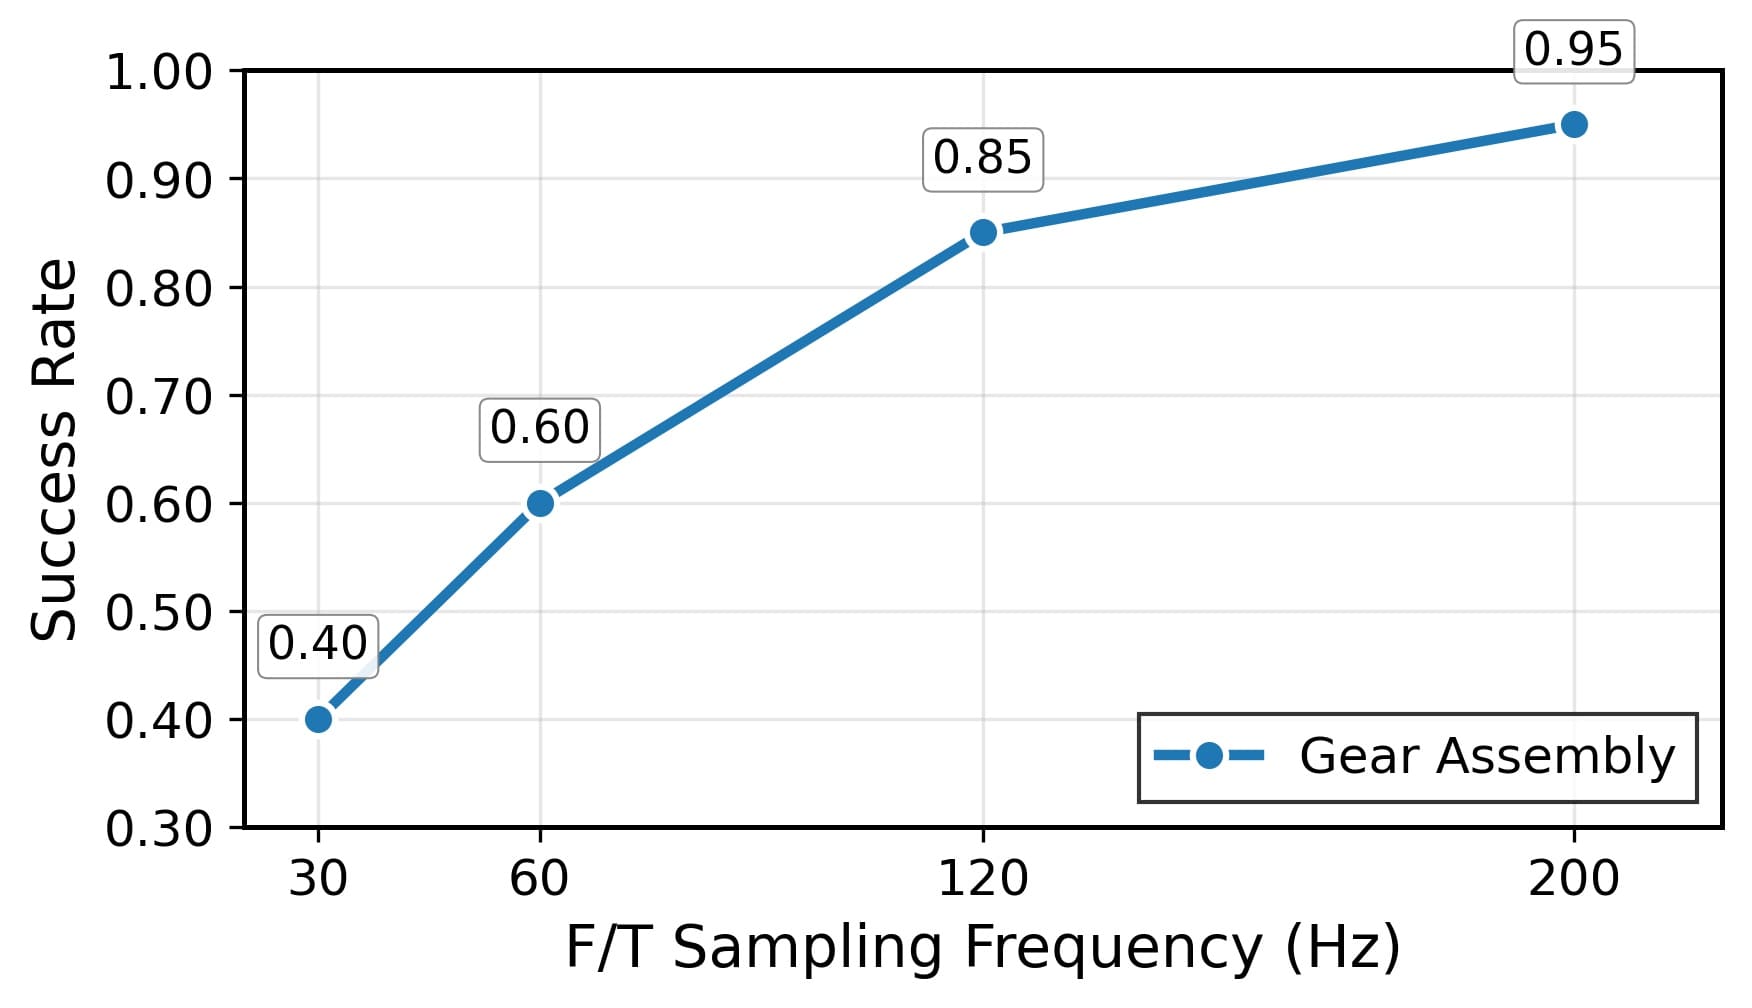
ManipForce 的价值在于把“接触示教怎么采”和“高频力觉怎么进策略”合成了一条闭环:手持系统用双目手眼 RGB、外部 3D ArUco 跟踪和腕部 AIDIN AFT200 六维 F/T 传感器记录自然人手示教,F/T 达 200Hz、RGB 和位姿为 30Hz;策略侧的 FMT 不把力信号降采样成图像帧的附属输入,而是用频率感知时间嵌入、模态嵌入和双向交叉注意力,把异步视觉 token 与力 token 融入 Transformer Diffusion Policy。六个真机任务上,FMT 平均成功率 83%,DINOv2-B 版 RGB-only Transformer DP 为 22%;最难的电池拆装/插入仍只有 65%/60%,说明力觉没有消除接触任务的全部不确定性。齿轮装配的 F/T 采样从 30Hz 提到 200Hz 时成功率 40%→95%,是论文最直接的频率证据。
关键词
摘要
中文摘要
精密装配等接触密集任务要求精确控制交互力,但现有模仿学习主要依赖纯视觉示教。论文提出 ManipForce,一个在自然人手示教中同时采集高频 F/T 与 RGB 的手持系统;并在此基础上提出 FMT。FMT 用频率感知和模态感知嵌入编码异步 RGB 与 F/T 信号,通过双向交叉注意力在 Transformer diffusion policy 内融合。六个真机接触密集任务上,使用 ManipForce 示教训练的 FMT 平均成功率为 83%,显著超过纯视觉基线;消融与采样频率分析进一步说明,高频 F/T 和跨模态集成对高精度、稳定接触任务尤其重要。
英文摘要
Contact-rich manipulation tasks such as precision assembly require precise control of interaction forces, yet existing imitation learning methods rely mainly on vision-only demonstrations. We propose ManipForce, a handheld system designed to capture high-frequency force–torque (F/T) and RGB data during natural human demonstrations for contact-rich manipulation. Building on these demonstrations, we introduce the Frequency-Aware Multimodal Transformer (FMT). FMT encodes asynchronous RGB and F/T signals using frequency- and modality-aware embeddings and fuses them via bi-directional cross-attention within a transformer diffusion policy. Through extensive experiments on six real-world contact-rich manipulation tasks—such as gear assembly, box flipping, and battery insertion—FMT trained on ManipForce demonstrations achieves robust performance with an average success rate of 83% across all tasks, substantially outperforming RGB-only baselines. Ablation and sampling-frequency analyses further confirm that incorporating high-frequency F/T data and cross-modal integration improves policy performance, especially in tasks demanding high precision and stable contact.
直观理解
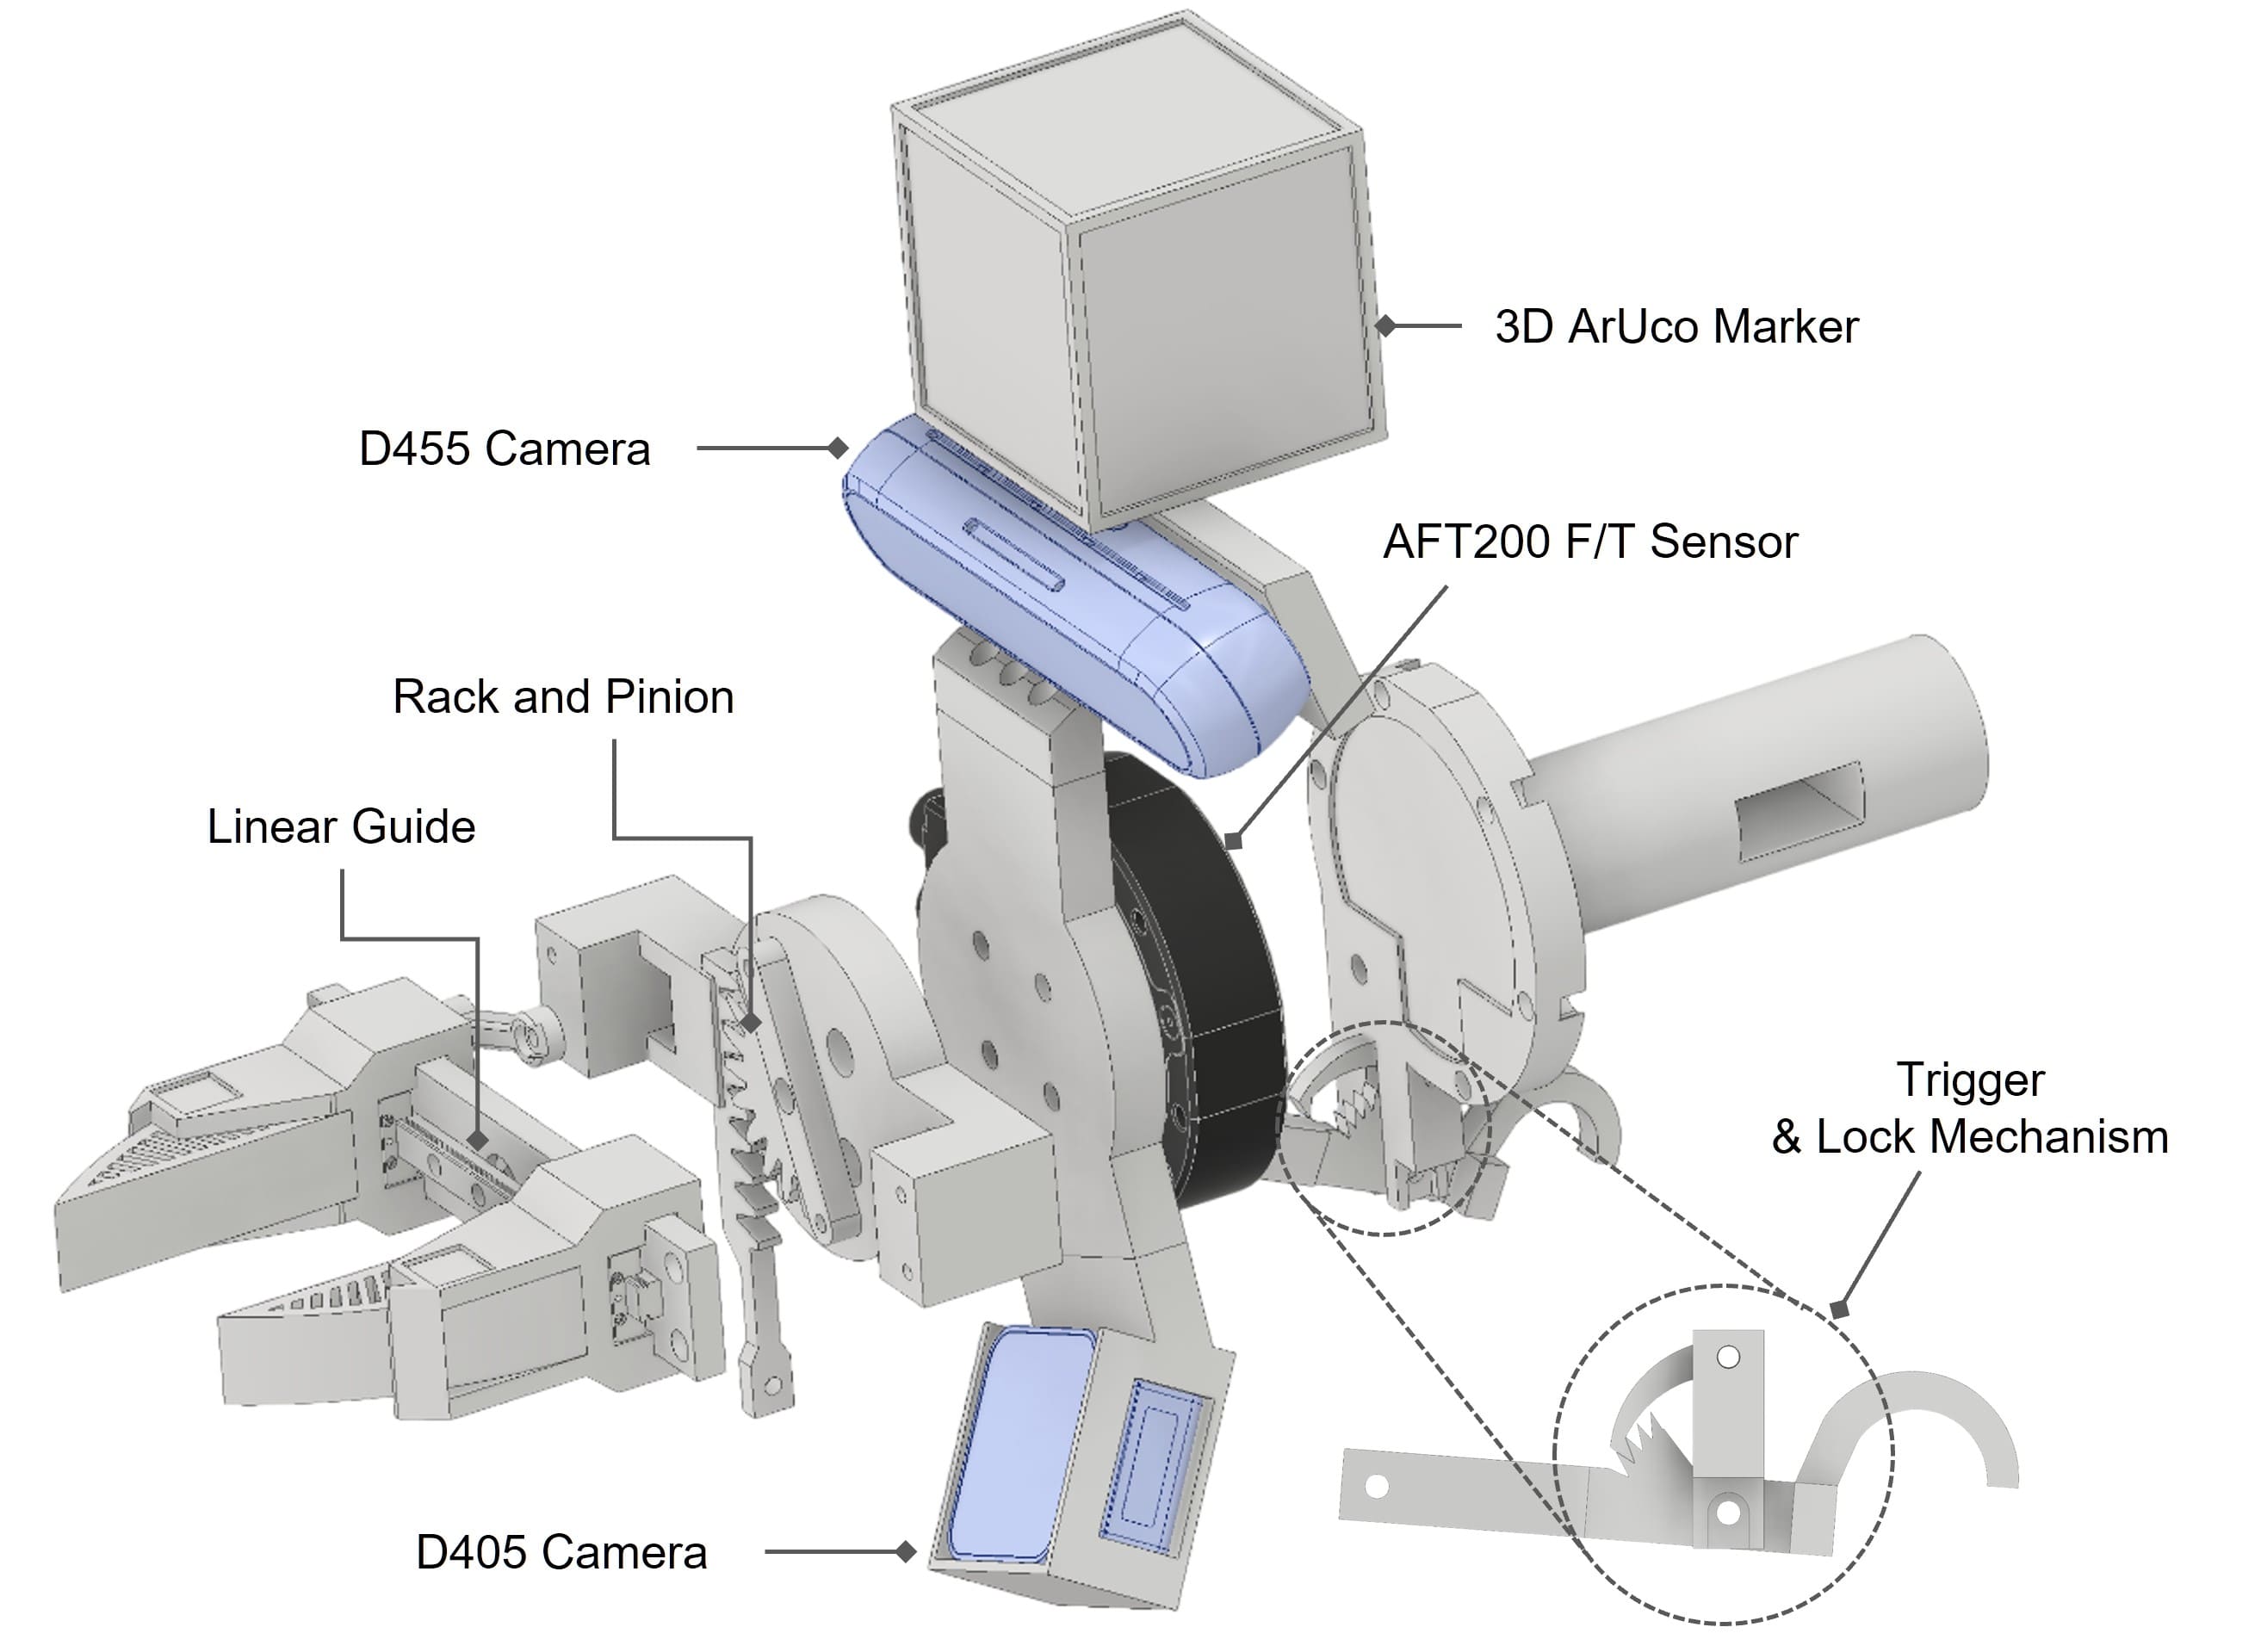
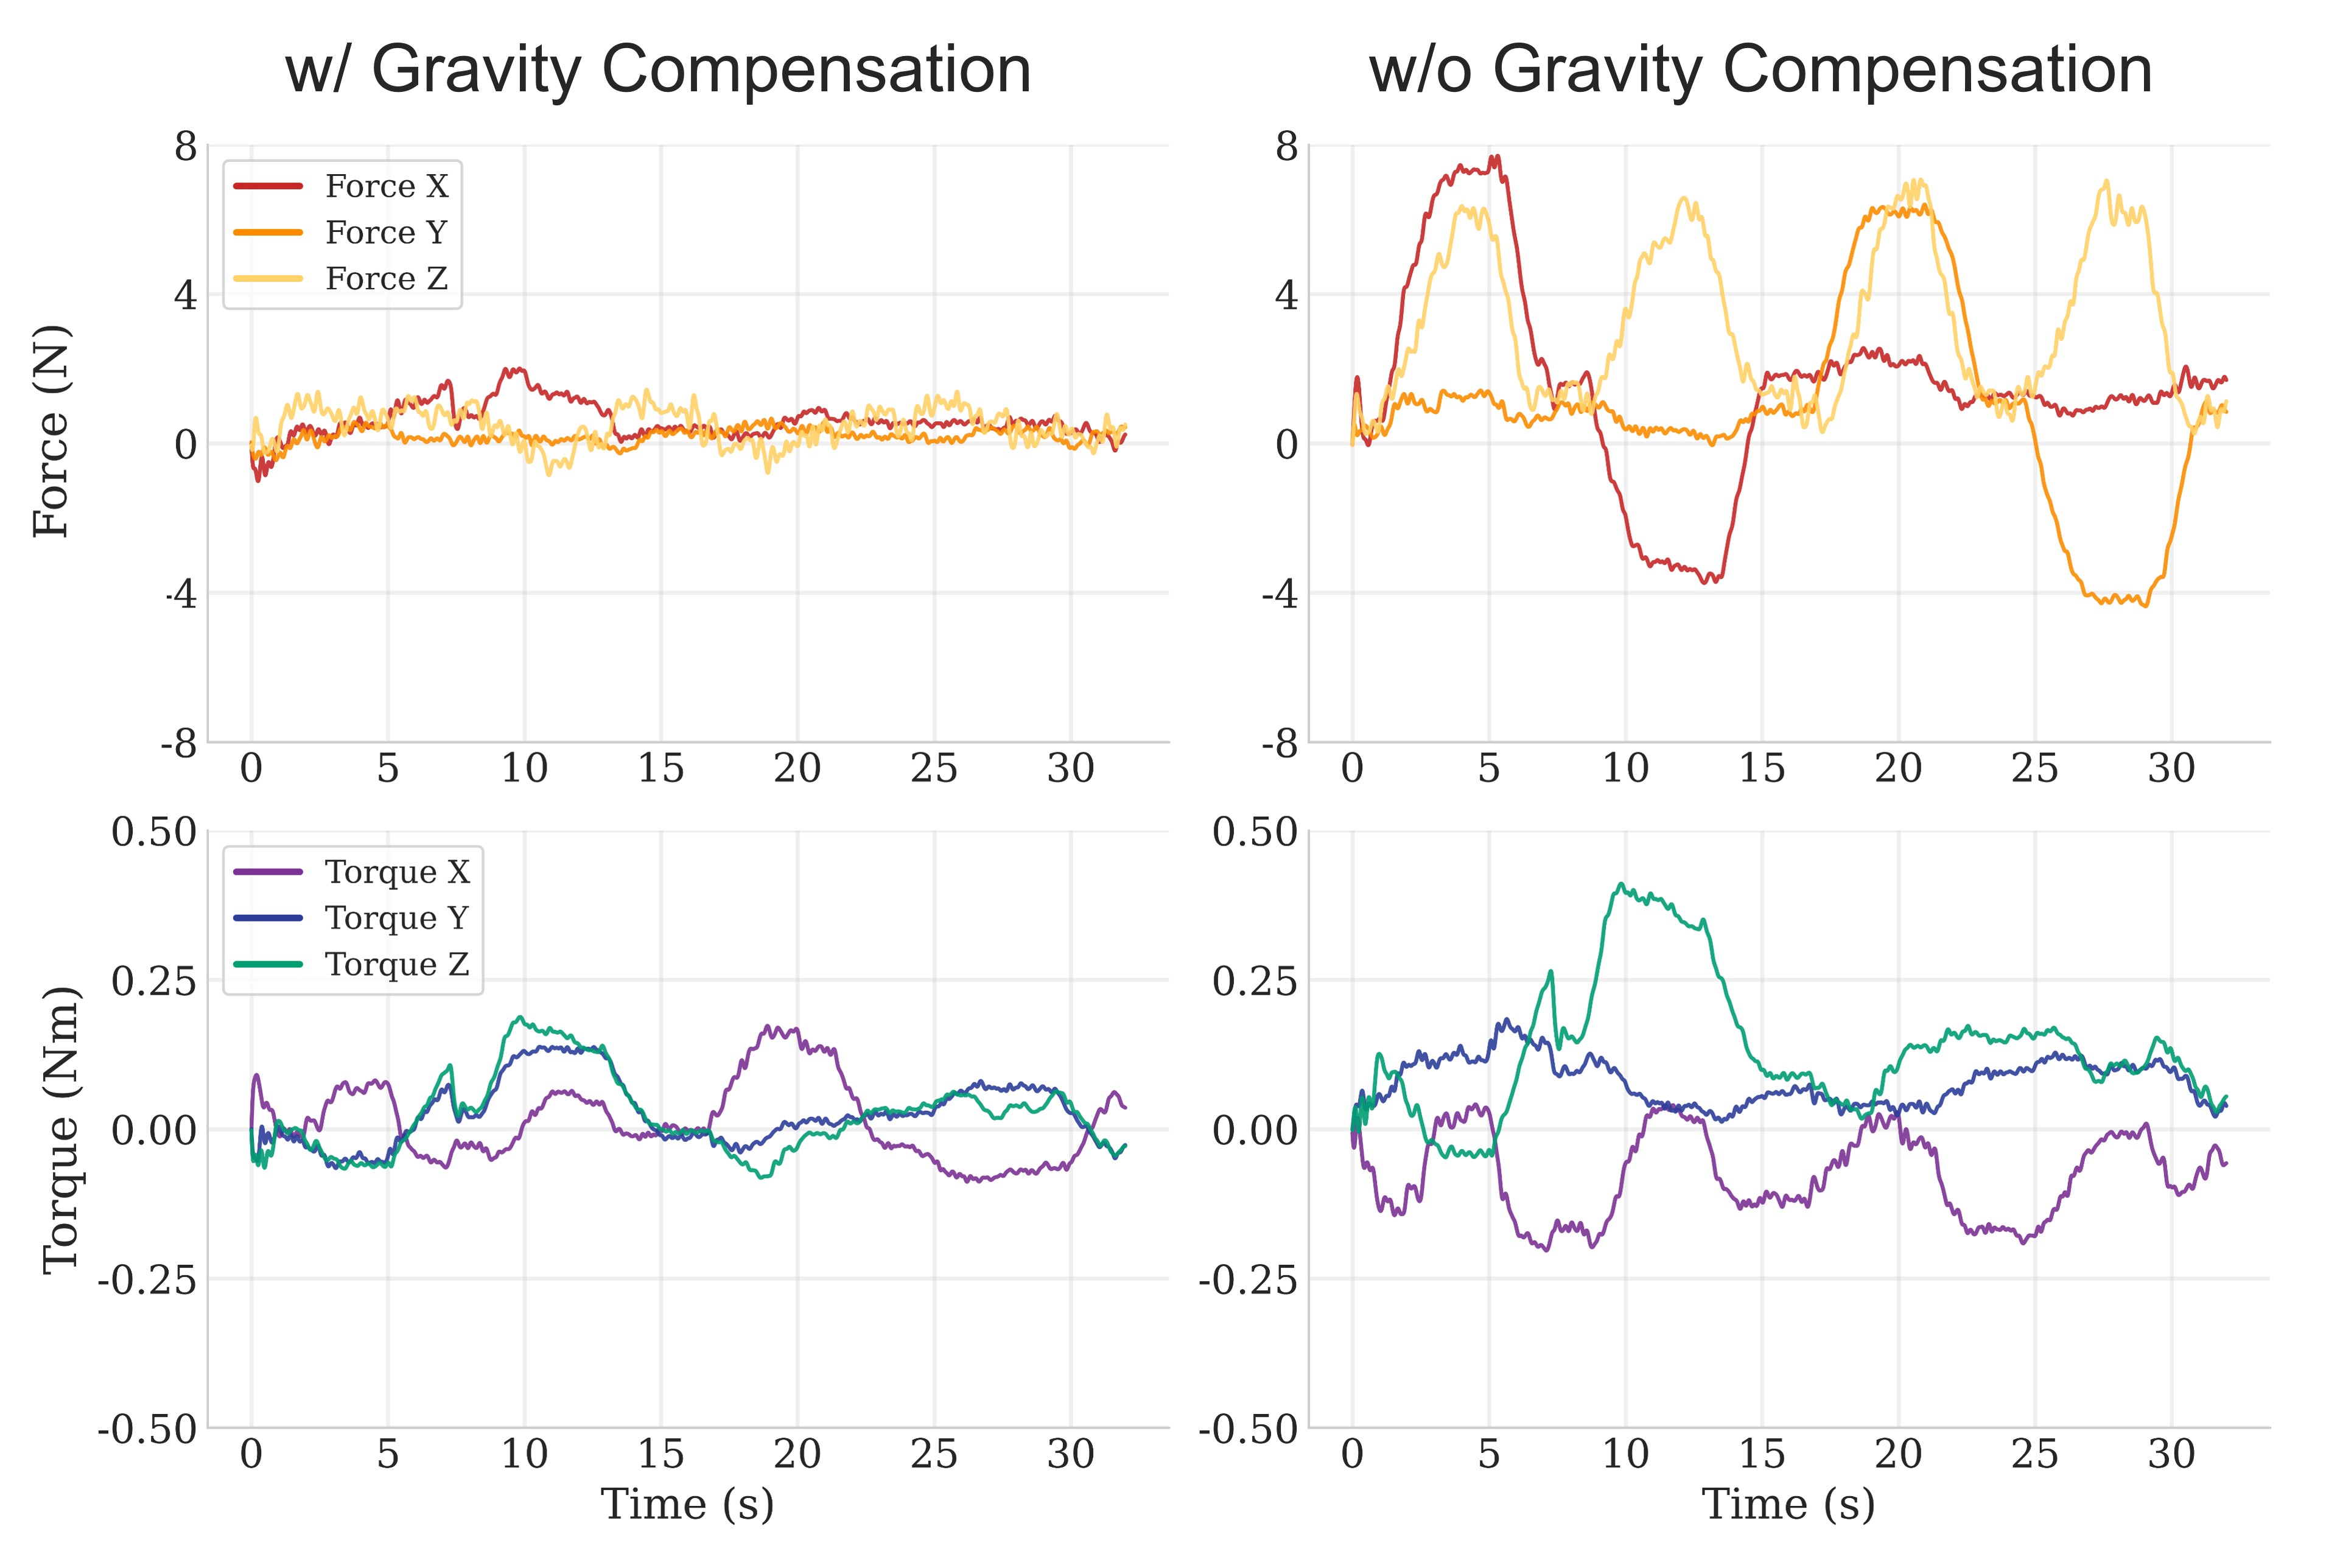
可以把 ManipForce 看成一个“让人手带力觉教学”的接口。UMI 类手持采集让示教接近自然操作,但主要追踪几何位姿,缺少接触力的监督;遥操作能保证本体一致,却慢且没有触觉反馈,人很难凭视觉施加准确接触力。ManipForce 的手持夹爪把所有夹爪部件放在 F/T 传感器下游,因此传感器记录的是夹爪与环境的真实交互 wrench,而不是人手施力的全部内力。双 RealSense 手眼相机负责小物体和细间隙,外部 Azure Kinect 通过 3D ArUco 跟踪替代容易在近表面退化的 SLAM,IMU 重力补偿再把工具自重从测量中扣掉。这样,机器人执行时只要保持相机、TCP 和传感器的几何关系,就能复用同一观测语义。
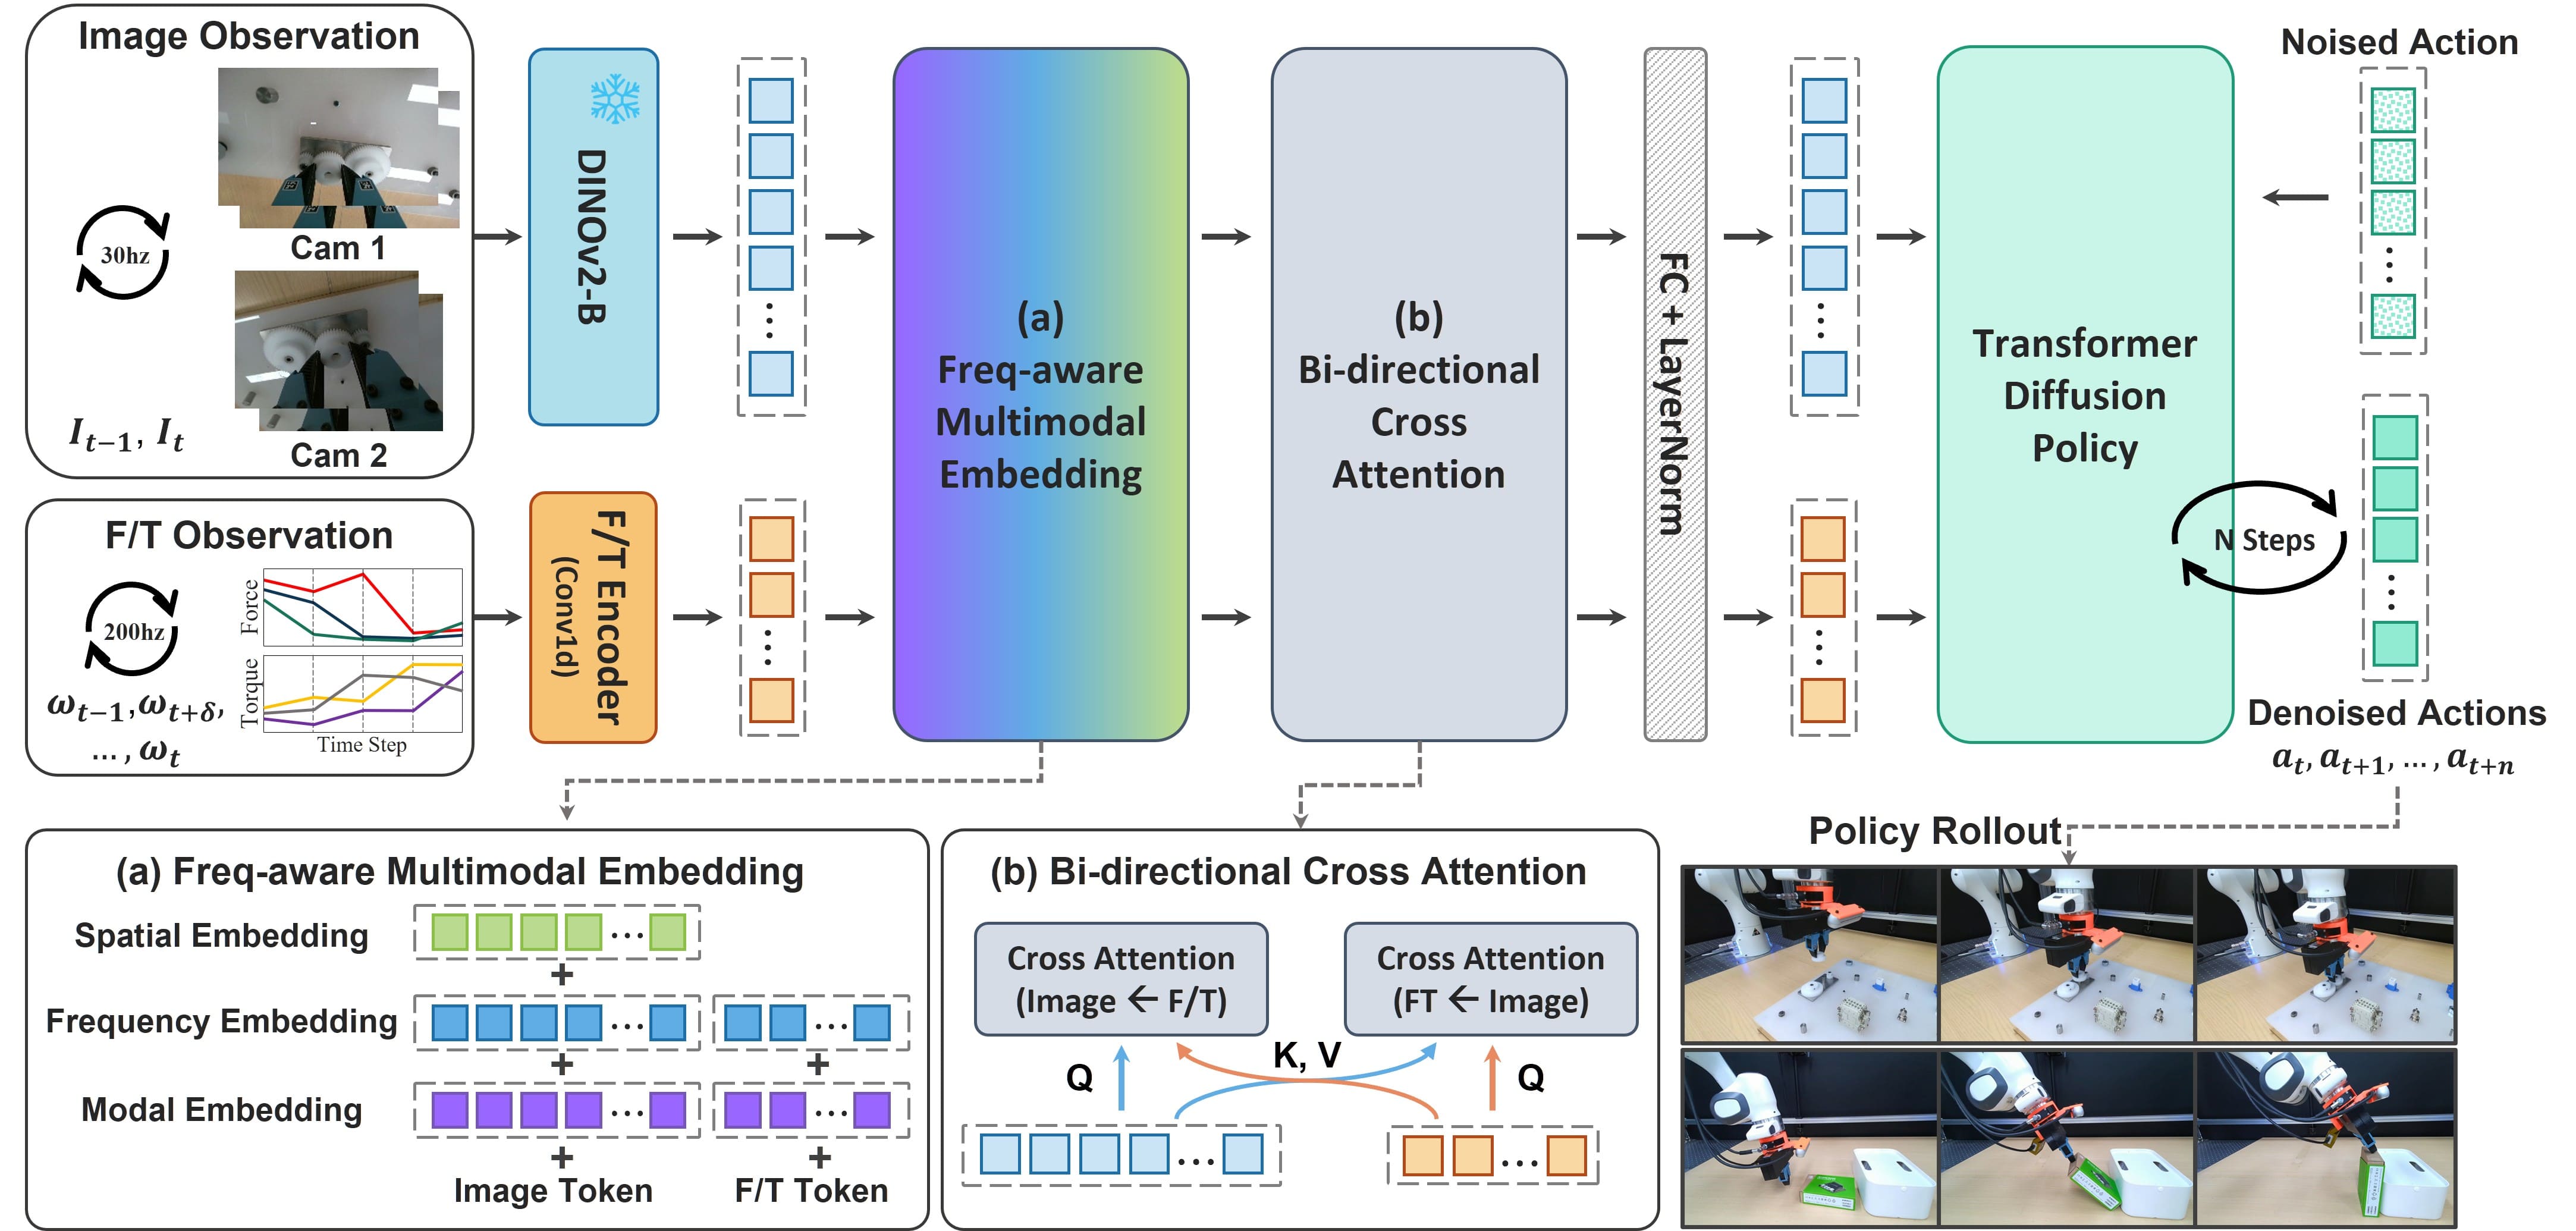
FMT 的关键则是不把 200Hz 力信号裁剪到 30Hz 视觉节奏。视觉用 DINOv2-B 变成空间 token,力用 1D CNN 变成时间 token;频率嵌入表示采样时间戳,模态嵌入区分两台相机和 F/T,视觉和力再互相做 cross-attention。这样,视觉 token 能读到接触瞬态,力 token 能知道自己在看哪个几何位置。它不显式输出目标力,而是让融合后的观测条件化动作扩散头,由部署侧 compliance controller 保障接触安全。
背景与问题
为什么做
齿轮装配、LAN 插头插入、开盖和电池拆装这类操作中,视觉误差会被小间隙和高刚度环境放大成卡滞或危险内力。人类示范者不仅知道“往哪里动”,也持续感知轴向阻力、旋转卡滞、瞬时尖峰和滑移;因此,接触密集模仿学习需要把这种力觉语义和几何观测一起记录下来。
问题缺口
现有手持采集系统如 UMI 降低了示教门槛,但没有腕部 F/T;ForceMimic 类系统加入视觉和力,却依赖深度点云、视觉 SLAM 和人工裁剪准备,在小物体、细间隙与近表面跟踪中既增加设置复杂度又损失精度。模型侧常见做法是把高频 F/T 降采样到图像频率后拼接特征,这会丢失短时接触尖峰和细粒度力变化;已有快慢架构也常把跨模态交互限制在低频视觉流中,缺少对异步采样率的显式统一表示。
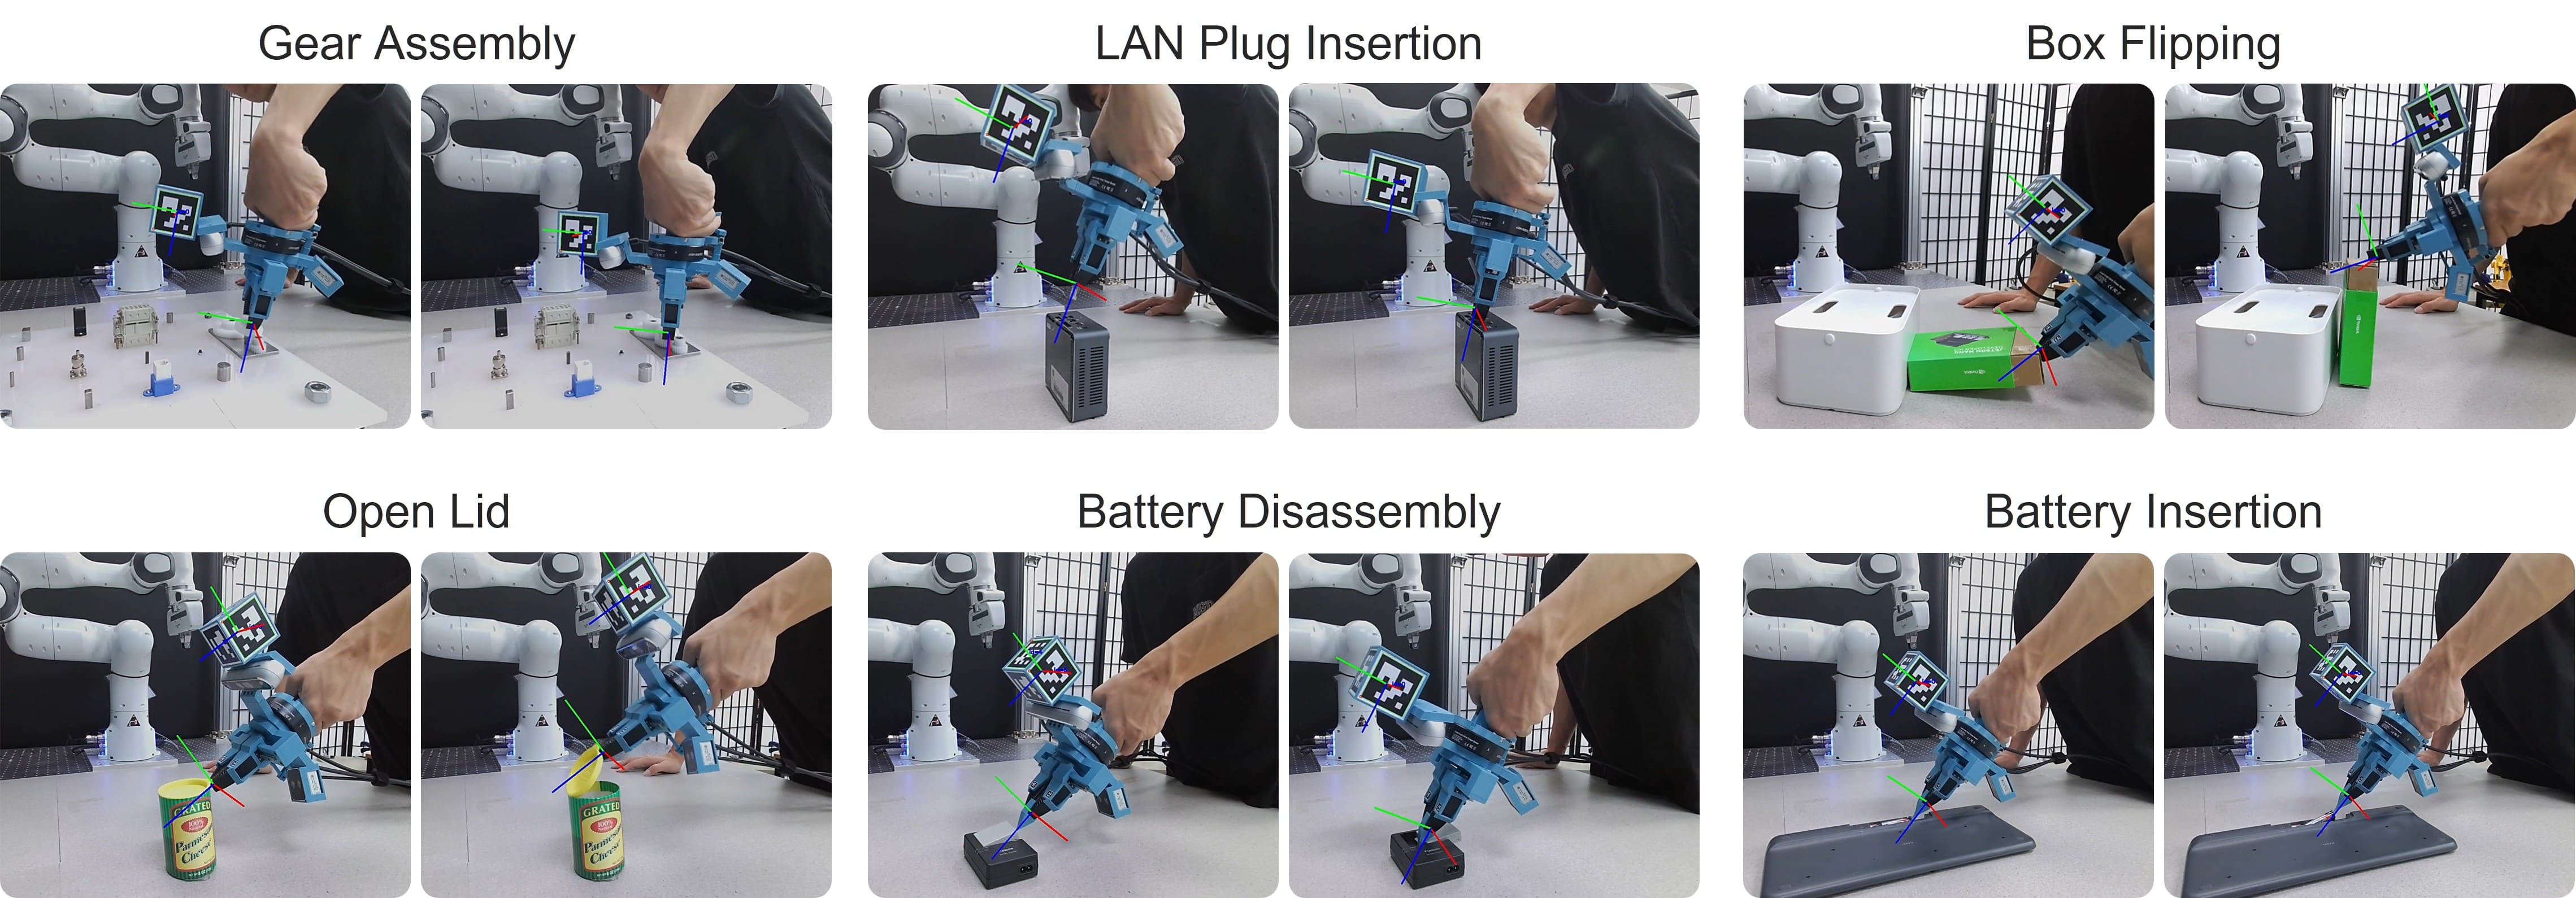
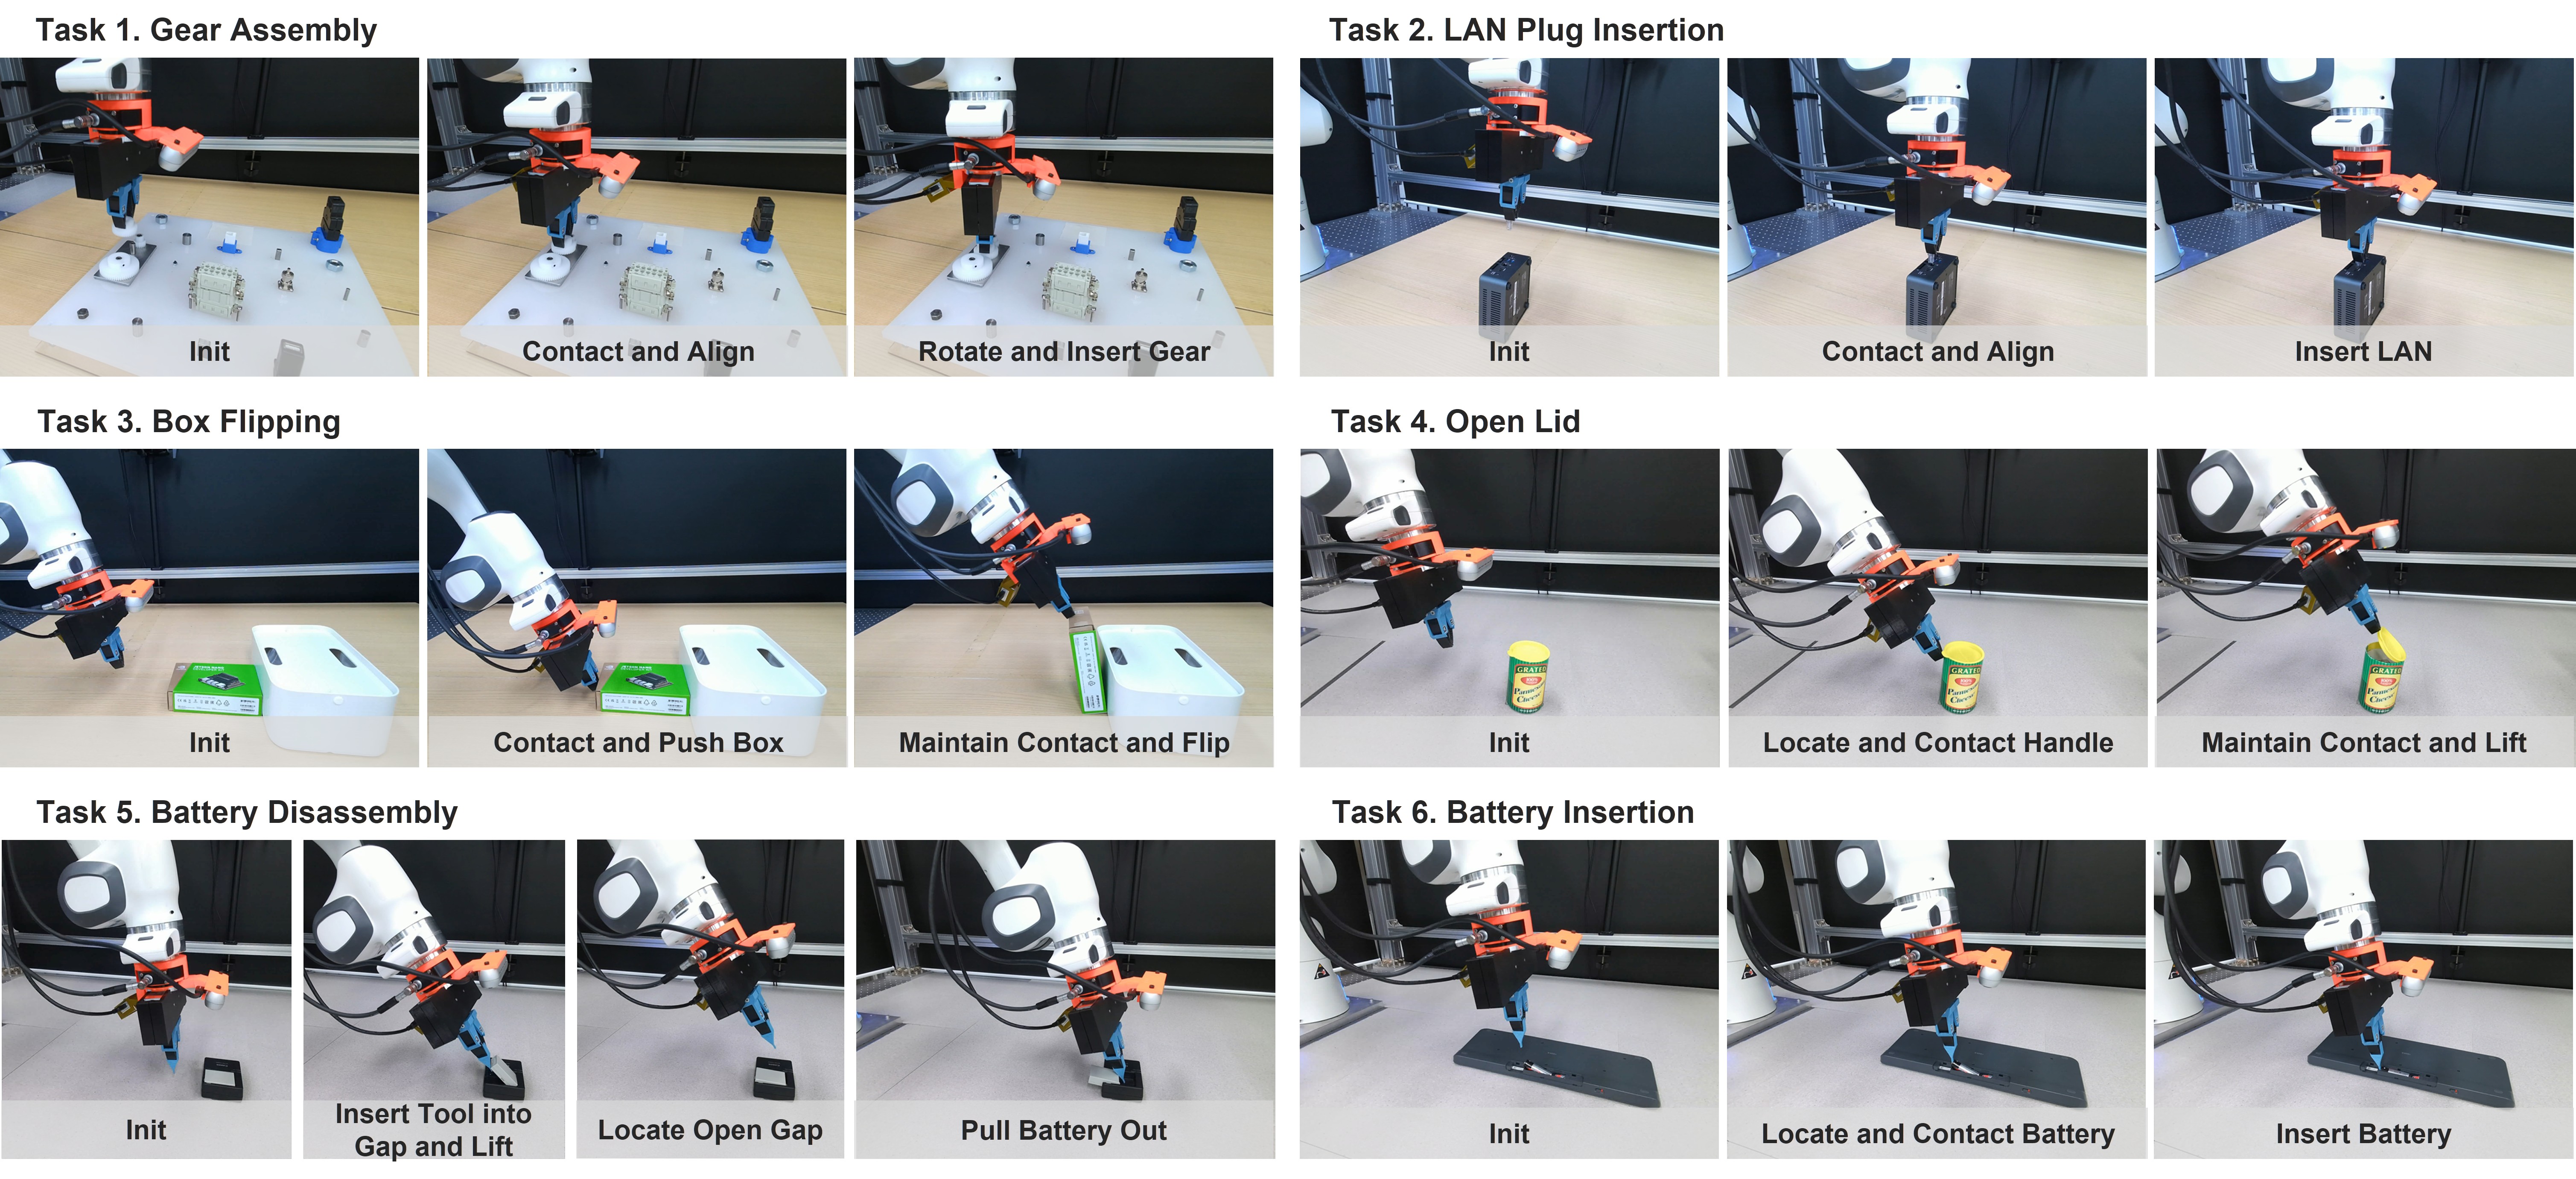
图 2:论文用齿轮装配、LAN 插头插入、盒子翻转、开盖、电池拆装和电池插入覆盖精密插入、非抓取翻滚、窄间隙工具插入和弹簧加载插入等不同接触模式。
方法
方法概述
ManipForce 由“数据接口”和“策略表示”两部分组成。数据接口用双相机、外部 3D ArUco、腕部 F/T、工具重力补偿和可锁定平行夹爪,把自然人类示教转换为可与 Franka 执行对齐的 RGB、位姿增量、夹爪状态和接触 wrench;策略侧 FMT 在共享 Transformer 表示中保留不同采样率,经双向视觉—力交叉注意力后条件化 Transformer Diffusion Policy 生成动作序列。
核心机制
FMT 的异步融合不是重采样到同一帧率,而是对每个 token 加上三类可学习信息:视觉 token 的空间位置嵌入、跨模态统一时间轴的频率感知嵌入、以及 camera-1/camera-2/F/T 的模态来源嵌入。视觉侧由 DINOv2-B 得到每帧 256 个 token,取两帧历史;F/T 侧由 1D CNN 得到 8 个时间 token,对应高频采样窗。随后视觉查询力/力矩键值,力/力矩查询视觉键值,双向增强后拼接、全连接和 LayerNorm,作为扩散动作头的观测条件。
关键要点
- ManipForce 的可迁移性来自采集与执行的传感器/相机几何一致,而不是靠任务特定在线校准。
- FMT 把“时间戳对齐”显式放进嵌入,而不是把高频力裁剪成低频图像附属特征。
- 双向交叉注意力让视觉提供接触的几何位置,力提供接触的阶段和动力学,二者不是简单拼接。
- 论文的动作输出仍是位姿/夹爪序列,F/T 是策略观测与表示,不是显式目标力输出。
结果
结果速览表
洞察
和已有方法的关系
- 相对 ForceMimic:ManipForce 避开深度点云和视觉 SLAM,改用双目手眼 RGB 与外部 3D ArUco,更适合小物体和细间隙;模型侧也不预测显式位姿—力控制参数,而是把 F/T 作为观测条件进入 diffusion policy。
- 相对 Reactive Diffusion Policy:RDP 用快慢结构在执行期修订动作,FMT 则在观测 tokenization 和表示融合层保留高频信息;二者解决的问题都在低频视觉与高频接触的时间尺度失配,但接口层级不同。
- 相对 CR-VLA-Force:CR-VLA-Force 输出期望力动作块并交给 500Hz 柔顺控制器,ManipForce/FMT 不显式输出力目标,接触安全更多依赖部署侧 compliance controller;因此它证明的是力觉观测价值,不是学习到的力控制目标语义。
- 相对 ForceFlow:ForceFlow 强调低维力对高维视觉的调制;FMT 的双向 cross-attention 让视觉和力互相提供上下文,并在同一 token 序列中显式学习频率与模态身份。
可借鉴点
- 设计手持示教工具时,把力传感器放在夹爪上游并保证机器人复用相同传感器坐标和相机—TCP几何,是降低分布偏移的关键。
- 多模态输入采样率差异很大时,优先保留时间戳和原始频率,再用可学习时间/模态嵌入统一表示,而不是把所有模态降到最低频率。
- 接触任务报告应包含采样频率消融;同是“有力输入”,30Hz 与 200Hz 的信息量可能完全不同。
- 对策略不输出力的系统,仍应在部署控制器中明确安全边界与滤波/柔顺策略,避免模型误判直接转化为过大力。
风险与判断
局限
适用场景
最终判断
值得跟踪。ManipForce 提供了一个清晰的系统路线:用自然手持示教降低数据采集成本,用高频 F/T 保存接触事件,用频率感知表示避免多模态信息被最低采样率截断。83% 平均成功率和高频消融是有力证据,但结论应限定为单平台、有限任务和内部基线比较;后续关键是跨机器人/跨传感器复现、外部力觉基线对比、峰值力与安全指标,以及无 ArUco 环境下的位姿跟踪稳定性。
相关主题
继续阅读
上一篇
TA-VLA: Elucidating the Design Space of Torque-aware Vision-Language-Action Models
TA-VLA 不是只提出一种新网络,而是系统回答力矩应该怎样进入预训练 VLA:关节力矩应接到动作解码器而非视觉语言编码器;一段力矩历史应先聚合成一个 token,而不是逐帧占用多个 token;训练时还应让模型联合预测未来动作与未来力矩。三项设计叠加后,π0 在五项接触密集任务上的总成功率从 23/100 提升到 86/100,在五项普通操作上仍从 85% 小幅升到 89%。证据说明廉价电机电流推算的关节力矩确实能补足视觉,但它不是经标定的末端接触力,跨机器人证据也仍很有限。
下一篇
Spatial Forcing: Implicit Spatial Representation Alignment for Vision-language-action Model
Spatial Forcing 用 VGGT 的多视角空间 latent 监督 VLA 中间层视觉 token,推理阶段不增结构,在 LIBERO 达到 98.5% 并带来 3.8× 训练效率提升。